Cómo conseguir citas en las respuestas de IA: lo que de verdad seleccionan ChatGPT, Perplexity y los AI Overviews de Google
En resumen
Lo que se cita no es la mejor página, sino el fragmento que mejor se deja extraer. Este resumen ordena las palancas según la evidencia: lo que funciona de forma demostrada, lo que solo se afirma y lo que es inútil. Queda la conclusión incómoda de que la visibilidad en las respuestas de IA es menos una cuestión técnica que una cuestión de si el contenido existe de verdad. scaile produce justo ese contenido.
Simon WilhelmCofundador
Simon es cofundador de scaile y trabaja con equipos de empresa en su visibilidad en la búsqueda con IA, desde la primera auditoría hasta cifras de cuota de voz que se pueden defender.
Puntos clave
Las palancas más fiables son poco espectaculares: accesibilidad para los rastreadores de IA, contenido actual, afirmaciones con fuentes y presencia en las fuentes en las que estos sistemas ya confían.
La densidad de evidencia se puede medir. En pruebas controladas, añadir citas, referencias a fuentes y estadísticas aumentó la visibilidad en respuestas generativas hasta en torno a un 40 %, con el mayor efecto en páginas que antes no estaban bien posicionadas.
El llms.txt hoy no sirve de nada. Un estudio de 137.000 sitios web comprobó que el 97 % de los dominios con este archivo no recibió ninguna petición de él, y Google indica que no hacen falta archivos de texto para IA para aparecer en sus funciones de IA.
Actualizar la evidencia obsoleta de las páginas útiles que ya existen. Cambiar solo la fecha no mejora una respuesta, y una página nueva necesita una pregunta propia a la que responder.
Al final, lo que decide es si la respuesta a la pregunta del cliente está escrita de verdad. scaile escribe exactamente esas respuestas, comprueba cada afirmación y las presenta a tu equipo para su aprobación, en los 14 días siguientes al onboarding.
Para recibir citas en las respuestas de IA hacen falta tres cosas: que los rastreadores de los proveedores de IA puedan llegar a las páginas, que esas páginas respondan a una pregunta concreta de forma completa y con pruebas, y que se hable de la empresa fuera de su propio dominio. El tercer punto sorprende a casi todo el mundo, pero es el de más peso: en las preguntas relacionadas con una marca, solo alrededor del 23 % de las citas procede del sitio web de la propia marca, y casi la mitad viene de fuentes de terceros.
Lo que en cambio aporta poco: los backlinks contados a la manera clásica, los grandes nombres de las relaciones públicas y el tan comentado archivo llms.txt.
Las tres cosas que sí funcionan son producción, no configuración, y por eso la mayoría de los programas se estanca después de los arreglos técnicos. scaile las gestiona como un único proceso: primero se extrae el conjunto de preguntas comerciales, después se investiga a partir de la base de conocimiento de tu empresa, se comprueba cada dato, tu equipo aprueba antes de que se publique nada y los artículos publicados se actualizan en la misma URL a medida que envejecen. En marcha en 14 días.
Cómo eligen sus fuentes los sistemas de IA
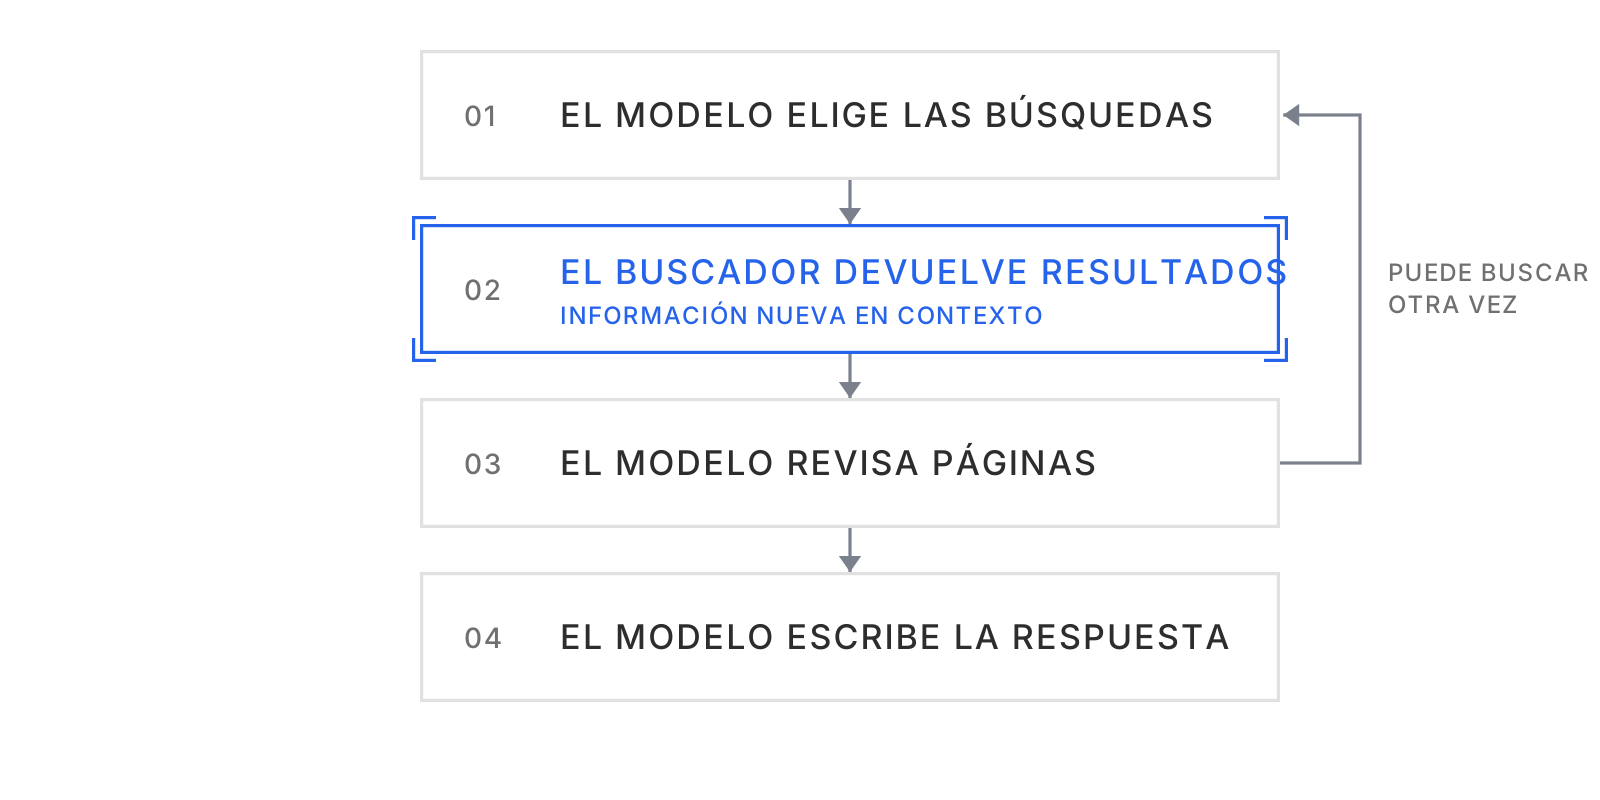
Los sistemas generativos no responden a todas las preguntas con una búsqueda. En ChatGPT, solo alrededor del 18 % de las conversaciones lanza al menos una búsqueda web, según un análisis de Profound sobre más de 700.000 conversaciones entre octubre y diciembre de 2025. El resto se responde con lo que ya está dentro del modelo. Para la visibilidad, eso significa que hay dos vías de entrada, el índice y el propio modelo, y que funcionan de forma distinta.
Cuando sí hay búsqueda, el sistema descompone la pregunta en varias subpreguntas y recupera fragmentos para cada una. Google llama oficialmente a este proceso query fan-out (despliegue de consultas) y lo usa tanto en los AI Overviews como en AI Mode. La consecuencia es que una página no necesita posicionar para la pregunta que se hizo, sino para alguna de las subpreguntas que el sistema deriva de ella. En los AI Overviews de Google, solo el 38 % de las URL citadas aparece entre los 10 primeros resultados de la propia consulta, mientras que el 31 % queda más allá de la posición 100, según un estudio de Ahrefs de marzo de 2026 sobre 863.000 páginas de resultados.
Las palancas, ordenadas por evidencia
Demostradas y documentadas
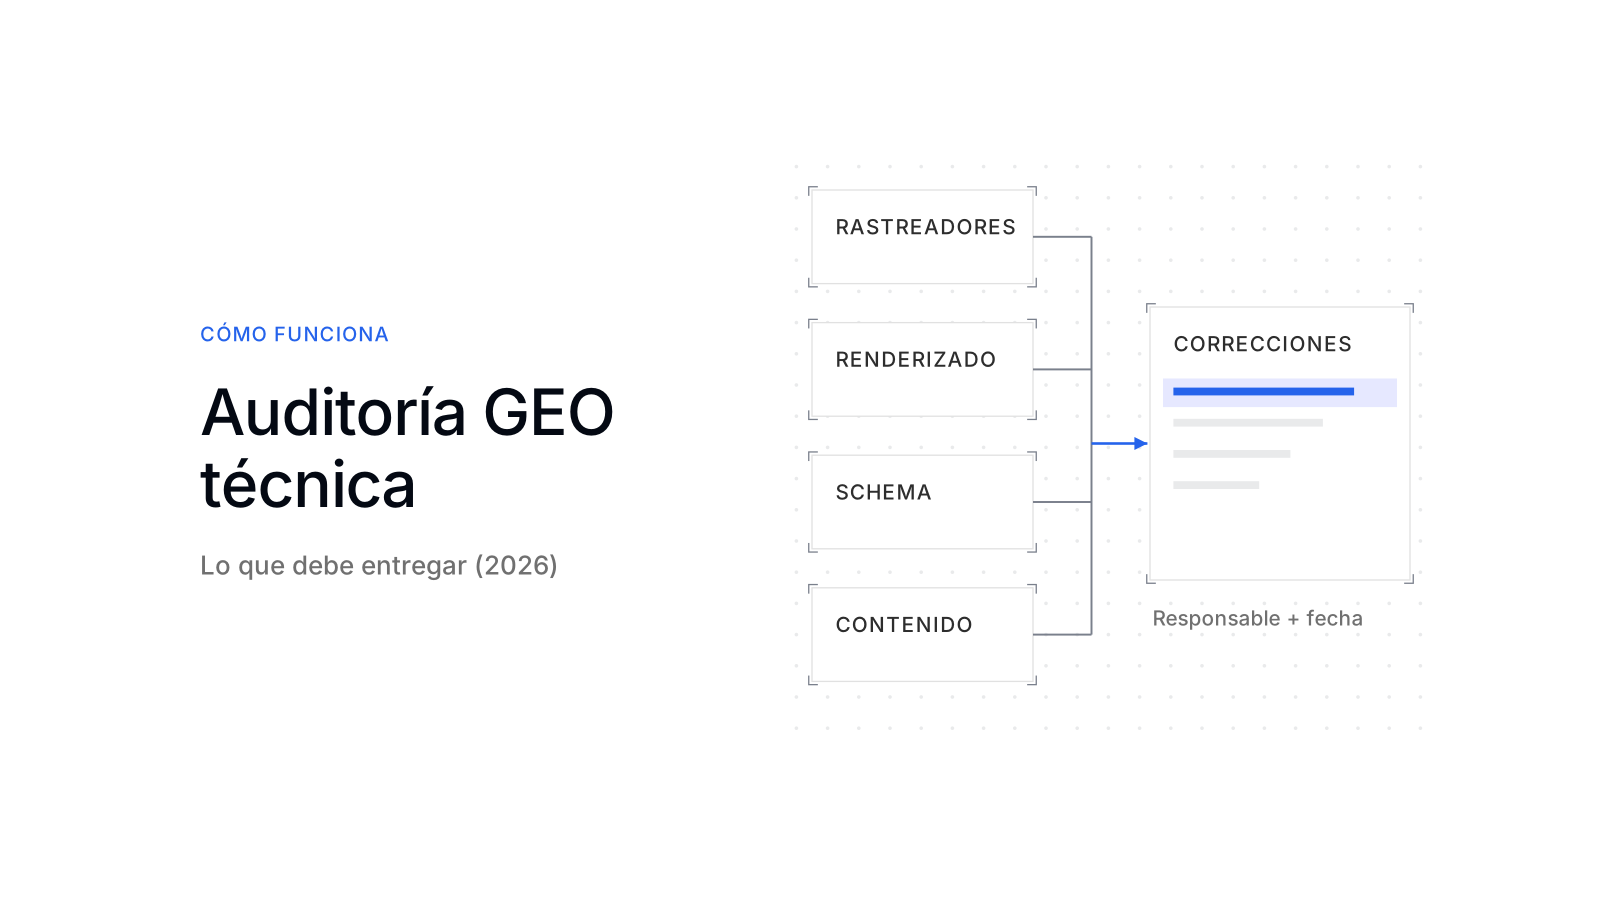
Accesibilidad para los rastreadores de IA. OpenAI documenta sus propios bots, entre ellos OAI-SearchBot para la búsqueda, que se controla por separado de GPTBot, el rastreador de entrenamiento. Bloquear OAI-SearchBot en el robots.txt o con un cortafuegos no vuelve el sitio menos visible: lo deja fuera de las respuestas de búsqueda de ChatGPT. El error más habitual en la práctica: el bot está permitido, pero la CDN lo bloquea por rango de IP (qué rastreadores de IA importan y lo que cuesta bloquearlos).
Indexación y posibilidad de mostrar fragmento en Google. Para los AI Overviews, Google establece un único requisito: la página tiene que estar indexada y poder mostrarse en la Búsqueda con un fragmento. Google indica también de forma explícita que no hacen falta nuevos archivos legibles por máquinas ni datos estructurados especiales.
Densidad de evidencia en el texto. En pruebas controladas, las citas, las referencias a fuentes y las estadísticas aumentaron la visibilidad en respuestas generativas hasta en torno a un 40 %. El efecto está repartido de forma desigual: las páginas que antes ocupaban la quinta posición fueron con diferencia las que más ganaron, mientras que la página que ya iba en cabeza perdió cuota. Para los proveedores más pequeños, es la mejor noticia de todo este tema.
Bien respaldadas por datos de terceros
Actualidad. El estudio de Ahrefs de julio de 2025 encontró que las URL citadas por los asistentes de IA de su muestra (ChatGPT, Perplexity, Copilot y Gemini) tenían de media 1.064 días de antigüedad. Ese resultado observacional no demuestra que actualizar rinda más que publicar artículos nuevos. Lo razonable es mantener al día las páginas útiles en la misma URL y publicar una página nueva cuando responda a una pregunta distinta que nadie ha respondido todavía.
Presencia fuera del propio dominio. En las preguntas relacionadas con una marca, solo alrededor del 23 % de las citas procede del contenido propio de la marca, el 48 % de menciones ganadas en medios y sitios de terceros, y el resto de fuentes comerciales. La lección no es descuidar el propio sitio web, sino saber que parte del trabajo ocurre fuera de él: en publicaciones del sector, listas comparativas, foros y directorios.
Estructura lista para responder. Un fragmento se cita cuando puede extraerse sin contexto. En la práctica eso significa la respuesta justo debajo de la pregunta, encabezados que son preguntas reales y la evidencia en el mismo párrafo que la afirmación.
Desmentidas o ineficaces
llms.txt. Un análisis de 137.000 sitios web comprobó que el 97 % de los dominios con este archivo no recibió ninguna petición de él. Google indica en su documentación que no hacen falta archivos de texto para IA, y su portavoz John Mueller ha dicho que el llms.txt no está pensado para la búsqueda. El archivo no perjudica, pero no sustituye a ninguna de las demás medidas.
Los backlinks como factor principal. En un estudio de Ahrefs sobre 75.000 marcas, las menciones de marca en la web se correlacionaban con la visibilidad en los AI Overviews mucho más (0,664) que el número de backlinks (0,218). Los enlaces siguen importando para la búsqueda clásica; aquí no son la palanca principal.
Los datos estructurados como garantía de citas. La guía de Google sobre funciones de IA no exige ningún marcado especial. Un schema correcto describe la página, pero ni la validación de la sintaxis ni añadir un campo garantizan la indexación o las citas. Un marcado engañoso puede infringir las directrices de Google. La lista de validación de datos estructurados sirve para comprobar los datos y el resultado publicado.
Registrarse en ChatGPT. No hay ningún directorio en el que inscribir la empresa. La única vía real de envío son los datos de producto para las compras en ChatGPT, mediante un feed de productos. Desde el 9 de febrero de 2026, OpenAI prueba anuncios en ChatGPT, pero, según OpenAI, se muestran separados de las respuestas, marcados como patrocinados, y no influyen en ellas.
Qué significa esto para el contenido
Si los asistentes describen una empresa equivocada o una oferta desactualizada, lo primero es una auditoría de entidad. Una página de grounding puede ordenar los datos aprobados, pero no obliga a ningún sistema a recuperarlos.
Si se suman las palancas demostradas, sale un orden sencillo. Primero, la accesibilidad técnica, que es un día de trabajo. Después, la cuestión de si en el sitio web existe de verdad una buena respuesta a los temas por los que la empresa quiere que la nombren. Y por último, el trabajo fuera del propio dominio.
El segundo punto es donde fracasa la mayoría de los programas. No porque sea difícil de entender, sino porque es trabajo: decenas de preguntas concretas de clientes, cada una con una respuesta completa, con fuentes y actual, en el lenguaje propio de la empresa. Una herramienta de medición muestra ese hueco con claridad; no lo cierra.
Para eso está hecho scaile. El motor detecta las preguntas que hacen los clientes justo antes de una decisión de compra, investiga a partir de la base de conocimiento de tu empresa y de fuentes actuales, comprueba cada dato y presenta cada artículo a tu equipo para su aprobación. Por el camino aprende de cada corrección, y recomendamos de forma explícita añadir conocimiento propio: la cifra, el caso de cliente, el criterio que solo tiene tu empresa. Es la parte que ningún competidor puede copiar y, para los sistemas de IA, la razón por la que se cita tu página y no la de otro.
El AI Visibility Check gratuito muestra dónde está tu empresa hoy. Si ya falta de forma visible en las respuestas, este diagnóstico acota la causa en media hora. Y como el contenido que resulta es editorial por naturaleza, conviene saber dónde recae la obligación de etiquetado de la Ley de IA de la UE: los artículos revisados por personas están exentos.
Preguntas frecuentes
¿Cómo se llega a las respuestas de ChatGPT?
Permitiendo a OAI-SearchBot, el rastreador de búsqueda de OpenAI, contando con respuestas actuales y con fuentes a las preguntas de los clientes y logrando menciones en páginas de terceros que ChatGPT ya cita. No existe ningún formulario de envío.
¿Se puede registrar una empresa en ChatGPT?
No. Solo existe una vía real de envío para los datos de producto de las compras en ChatGPT. Todo lo demás sale del contenido y de las menciones.
¿Sirve de algo el llms.txt?
Hoy por hoy, no. En un estudio, el 97 % de los dominios con este archivo no recibió ninguna petición de él, y Google indica que no hacen falta archivos de texto para IA para aparecer en sus funciones de IA.
¿Cuánto tarda una página en recibir citas?
Con un conjunto de preguntas bien acotado, según la experiencia de scaile, las primeras citas en IA suelen llegar entre los 7 y los 14 días, y el movimiento medible en la cuota de voz se ve dentro del primer trimestre.
¿Cuenta lo mismo para las respuestas de IA que para Google?
En parte. La indexación y la limpieza técnica son un requisito compartido, pero la selección de fuentes difiere mucho: en los AI Overviews de Google, solo el 38 % de las URL citadas aparece entre los 10 primeros resultados de la consulta.
¿Hace falta estar activo en Reddit?
Es útil, pero no imprescindible. En el análisis de Profound sobre ChatGPT, Reddit es la segunda fuente más citada, después de Wikipedia, con alrededor del 3 % de todas las citas. Conviene comprobar qué fuentes citan los asistentes en el propio sector antes de invertir en una plataforma concreta.
Conocemos las tres palancas. ¿Quién las mueve cada mes?
Esa es la parte que decide el resultado, y es un problema de constancia: las respuestas hay que seguir escribiéndolas, mantenerlas al día y con fuentes. scaile lo hace como infraestructura gestionada, con un estratega de AI search asignado, investigación a partir de la base de conocimiento de tu empresa, verificación de cada afirmación y tu equipo aprobando antes de publicar, en marcha en 14 días. Building Radar duplicó sus leads inbound cualificados en 90 días con este sistema.
Fuentes
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Lewis et al. Por qué las respuestas se construyen a partir de fragmentos recuperados.
- GEO: Generative Engine Optimization, Aggarwal et al., KDD 2024. El efecto de la densidad de evidencia (hasta un 40 %) y su efecto desigual, que favorece a las páginas peor posicionadas.
- Google Search Central: AI features and your website. La indexación y la posibilidad de mostrar fragmento como único requisito, sin archivos especiales, y el query fan-out.
- OpenAI: Overview of OpenAI Crawlers. OAI-SearchBot, GPTBot y ChatGPT-User, y cómo se controla cada uno.
- Ahrefs: estudio sobre llms.txt, 15 de junio de 2026. El 97 % de los dominios con llms.txt no recibió ninguna petición del archivo; incluye la declaración de John Mueller.
- Ahrefs: citas de los AI Overviews y el top 10, 2 de marzo de 2026. El 38 % de las URL citadas en los AI Overviews está en el top 10 de la consulta y el 31 % más allá de la posición 100.
- Ahrefs: 17 millones de citas y la actualidad del contenido, 28 de julio de 2025. Estudio observacional; la antigüedad media de las URL citadas por los asistentes de IA de la muestra era de 1.064 días. No es un umbral de antigüedad universal ni prueba de que cambiar una fecha provoque citas.
- Ahrefs: factores de visibilidad de marca en los AI Overviews, 26 de mayo de 2025. 75.000 marcas; correlación de las menciones de marca (0,664) frente a los backlinks (0,218).
- Omniscient Digital: de dónde salen las citas de la IA, 8 de enero de 2026. Reparto entre fuentes propias, ganadas y comerciales en las preguntas relacionadas con una marca.
- Profound: fuentes de las citas de ChatGPT, 3 de febrero de 2026. Cuota de conversaciones que lanzan una búsqueda y fuentes más citadas.
- OpenAI: Testing ads in ChatGPT, 9 de febrero de 2026. Los anuncios se muestran separados y no influyen en las respuestas.
- OpenAI: Commerce. El feed de productos para que ChatGPT indexe y muestre los productos de un comercio.