Cómo funciona la búsqueda de ChatGPT de OpenAI: lo que hace el LLM antes de responder
En resumen
GPT se apoya en el conocimiento aprendido y en la información que recupera con herramientas. scaile rastreó 200 ejecuciones de Codex para entender cómo las búsquedas y las comprobaciones de páginas dan forma a una respuesta, y dónde un contenido mejor podría marcar la diferencia.
August GutscheCofundador y CPO
August es cofundador y CPO de scaile y dirige el producto: el motor de investigación, redacción y publicación detrás de la visibilidad en la búsqueda con IA.
Para entender cómo responde a una pregunta un modelo de lenguaje grande (LLM), hay que empezar por dos cosas:
- Lo que aprendió durante el entrenamiento.
- Lo que encuentra con herramientas mientras responde.
Lo primero le da al modelo un punto de partida. Lo segundo aporta información que puede usar para comprobar, ampliar o corregir ese punto de partida.
Para las marcas, esto importa. Una página útil puede pasar a formar parte de la información que recibe el modelo antes de escribir su respuesta.
scaile estudió este proceso en Codex, el asistente de programación de OpenAI, rastreando las búsquedas y las comprobaciones de páginas que hay detrás de las respuestas generadas por GPT. El 9 de septiembre de 2026, scaile pasó 100 prompts de compradores dos veces por Codex y registró cada consulta de búsqueda, cada apertura de página y cada comprobación dentro de una página que hizo el modelo antes de responder.
El entrenamiento le da conocimiento. Las herramientas le traen información.
| Fuente | Lo que aporta |
|---|---|
| Entrenamiento | Conocimiento aprendido, patrones de lenguaje y asociaciones |
| Llamadas a herramientas | Información recuperada para la tarea en curso, como resultados de búsqueda y contenido de páginas |
Las llamadas a herramientas no reescriben los datos de entrenamiento durante una búsqueda. Añaden información a la conversación en curso que puede influir en la respuesta. OpenAI lo describe como conocimiento aprendido frente a información aportada en el contexto. La explicación de OpenAI
El prompt, las instrucciones y el historial de la conversación también condicionan cómo usa el modelo ambas cosas.
¿Qué pasa entre el prompt y la respuesta?
El modelo trabaja dentro de un harness (el entorno de ejecución): el software que le da instrucciones, ejecuta sus llamadas a herramientas y le devuelve los resultados.
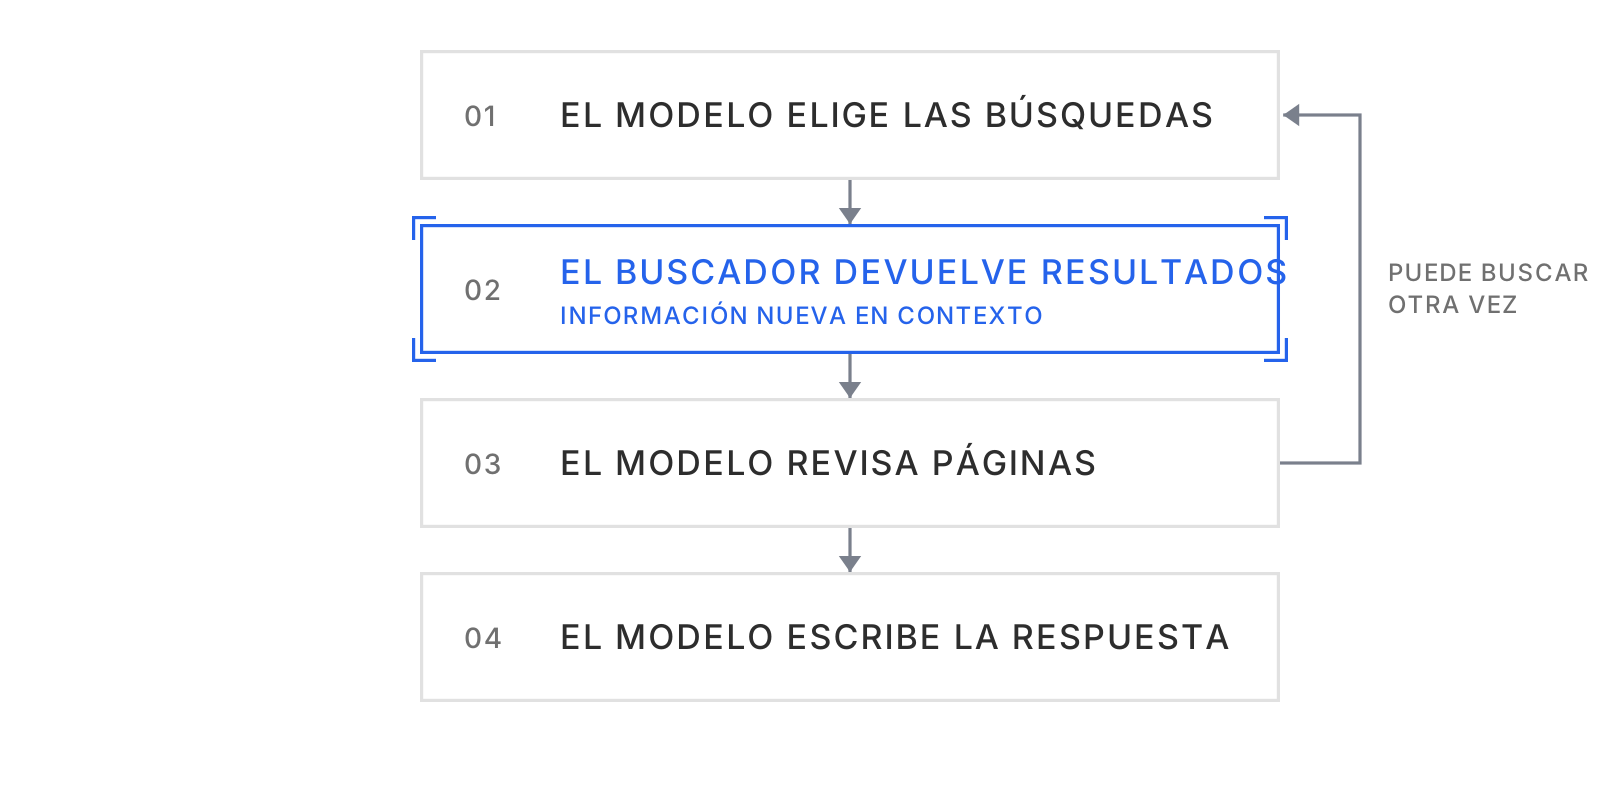
En el estudio de scaile, el modelo tomaba pronto una decisión sobre su siguiente acción. El harness la ejecutaba. La actividad web solía empezar con búsquedas, seguidas de la apertura de algunas páginas seleccionadas y de comprobaciones de detalles:
- Elegir búsquedas. El modelo convierte la tarea en consultas de búsqueda.
- Recuperar resultados. La herramienta devuelve títulos, URL, fragmentos y, a veces, extractos más largos.
- Comprobar páginas seleccionadas. El modelo pide abrir páginas, busca dentro de ellas o lanza consultas de seguimiento.
- Escribir la respuesta. El modelo usa su conocimiento previo y la información que le devuelven las herramientas.

El 9 de septiembre de 2026, scaile ejecutó 100 prompts dos veces:
| Observación | Resultado |
|---|---|
| Ejecuciones que usaron herramientas web | 188 de 200 |
| Primera llamada web solo con búsquedas | 180 de esas 188 |
| Tiempo hasta la primera acción con herramientas, mediana | 7,9 segundos |
| Peticiones de apertura de página por ejecución con uso web, mediana | 5 |
La primera acción con herramientas también podía ser una pregunta de aclaración u otra herramienta. El tiempo no mide solo la búsqueda. Datos del estudio.
El patrón: el sistema empieza pronto a reunir información y después comprueba detalles seleccionados antes de responder. Esto describe la configuración probada, no todos los productos o modos de GPT.
Por qué importa la capa de búsqueda para el contenido
Una respuesta final dice si una marca apareció. Las llamadas a herramientas ayudan a explicar qué información estuvo disponible por el camino.
¿Qué consultas eligió el modelo? ¿Qué páginas volvieron? ¿Qué texto se devolvió? ¿Qué páginas abrió después?
En una ejecución guardada sobre cómo ejecutar trabajo de SEO y GEO, el modelo buscó flujos de trabajo de contenido y publicación en CMS, abrió páginas de inicio de proveedores, páginas de precios y documentación, y después buscó dentro de las páginas términos como Publish y $.
Eso le da a un equipo de contenido una pregunta concreta: ¿responde la página con claridad a la pregunta de funcionalidades o de precio que el modelo está comprobando?
El conocimiento de partida puede influir en las búsquedas. El contenido devuelto puede influir en las búsquedas siguientes y en la respuesta. Entender ese ciclo ayuda a scaile a identificar cambios de contenido que merece la pena probar. OpenAI también describe este proceso de buscar, revisar los resultados y decidir si seguir buscando. Guía de búsqueda web
Una ejecución, de la pregunta del comprador a la prueba de contenido
Esta es la ejecución guardada completa, tal como la registró scaile. Los nombres de proveedores en las consultas del propio modelo se sustituyen por <vendor>; todo lo demás es literal.
| Paso | Lo que muestra la traza |
|---|---|
| Pregunta del comprador | “What is the best tool for executing on my SEO and GEO data to actually become visible in AI search?” (“¿Cuál es la mejor herramienta para ejecutar a partir de mis datos de SEO y GEO y hacerme visible de verdad en la búsqueda con IA?”) |
| Primeras consultas de búsqueda | AI search optimization platform execute recommendations content technical SEO <vendor> <vendor> <vendor>, y después una consulta por proveedor, como site:<vendor> AI search content workflows integrations |
| Consulta de seguimiento | site:<vendor> integrations Google Search Console Semrush Ahrefs CMS publish |
| Páginas que abrió | La página de inicio del proveedor, su página de precios, el índice de su documentación, luego la página de integraciones dentro de la documentación y, por último, la página de precios de un competidor |
| Lo que buscó dentro de esas páginas | Publish, publish, $, Solo, Agents |
| Cambio de contenido para probar | Una página de integraciones que nombre las conexiones con el CMS y el paso de publicación con palabras claras, y una página de precios que indique los nombres de los planes y el precio, para que las comprobaciones del modelo dentro de la página de “publish” y ”$” encuentren texto real |
El modelo nunca le pidió al proveedor que se describiera. Preguntó si el producto se conecta a un CMS y publica, y cuánto cuesta, y comprobó esas dos cosas en las páginas que abrió. Una página que responda a ambas de forma explícita es la prueba de contenido que scaile haría primero para esa pregunta de comprador.
Alpha permite a scaile inspeccionar un paso directamente
En la configuración de Codex que estudió scaile, las peticiones de herramientas web iban a:
POST https://chatgpt.com/backend-api/codex/alpha/searchUn endpoint es una dirección a la que el software envía peticiones. Alpha acepta una orden de búsqueda directa. Esta parte de una petición fija la consulta:
{
  "commands": {
    "search_query": [{ "q": "Software Agentur Wien" }]
  }
}
scaile puede inspeccionar las páginas devueltas sin pedirle a un modelo que elija esa consulta ni que escriba una respuesta.
Bajar una capa más significa separar el paso de búsqueda de las decisiones que el modelo toma a su alrededor.
Para probarlo con un sitio web propio: el GPT Search Check gratuito de scaile (disponible solo en inglés) envía el dominio y hasta tres consultas a este endpoint y manda por correo las páginas que devuelve.

¿En qué se diferencia de Responses?
Con la API pública Responses, se le da al modelo un prompt y se activa la búsqueda web. El modelo construye la llamada de búsqueda.
| Pregunta | Alpha | Responses con búsqueda web |
|---|---|---|
| ¿Cómo se indica la consulta? | Directamente, en una orden de búsqueda | Mediante instrucciones al modelo |
| ¿Se pueden inspeccionar las páginas devueltas? | Sí | Sí, si se solicita |
| ¿Recibió scaile extractos y etiquetas de rastreo? | Sí | Sí |
| Uso principal en esta investigación | Inspeccionar una consulta de búsqueda exacta | Inspeccionar el proceso de búsqueda y respuesta del modelo |
Responses expone los resultados detallados con web_search_call.results y las URL de las fuentes con web_search_call.action.sources. Para ver la consulta real, hay que mirar action.queries. Referencia de Responses
En la comparación de scaile del 17 de septiembre, todas las llamadas a la API pública siguieron exactamente la consulta solicitada. Lo que distingue a Alpha es el control directo por orden, en lugar de depender de que el modelo siga esa instrucción.
Aun así, las listas fueron distintas. Para Software Agentur Wien, el primer ensayo emparejado devolvió 27 resultados con Alpha y 21 con Responses, con 16 URL exactas en común. Como los controles del presupuesto de salida eran distintos, esto no demuestra por qué difirieron las listas. Datos de la comparación.
Convertir la evidencia de búsqueda en pruebas de contenido
Inspeccionar las llamadas a herramientas convierte “aparecer en la respuesta de GPT” en trabajo concreto:
| Lo que muestra la traza | Cambio de contenido para probar |
|---|---|
| Las consultas se centran en una tarea concreta | Explicar cómo realiza el producto esa tarea |
| Al texto devuelto le falta una funcionalidad clave | Hacer explícita esa funcionalidad en el contenido de las páginas pertinentes |
| El modelo comprueba precios o integraciones | Ofrecer datos claros y actuales, con evidencia que los respalde |
| Una página aparece, pero la marca no se recomienda | Comprobar si la página responde a los requisitos del usuario |
Son hipótesis. Las trazas no revelan una fórmula de posicionamiento completa ni demuestran que un estilo de redacción provoque una recomendación.
El método: mantener fijos los prompts de compradores, cambiar una parte sustancial del contenido, repetir las comprobaciones y comparar con una página sin cambios. Aparecer entre los resultados, recibir una cita y recibir una recomendación se miden por separado.
Entender qué busca el modelo, mejorar la evidencia que puede encontrar y medir si cambia la respuesta final. Esa es la oportunidad que abre esta investigación.
Siguiente paso: el AI Visibility Check gratuito de scaile muestra si la IA nombra hoy a tu empresa cuando los compradores preguntan por tu categoría.
Alcance de la investigación: el estudio del proceso usó Codex con gpt-6-astra con esfuerzo xhigh el 9 de septiembre de 2026. La comparación separada entre Alpha y Responses usó cinco peticiones a Alpha y seis a la API pública el 17 de septiembre. Estas observaciones describen configuraciones concretas, no un posicionamiento universal de ChatGPT ni una demostración controlada de una mejora causada por el contenido.