Cómo decidir qué prompts seguir para una marca y cómo medir lo que cambió
En resumen
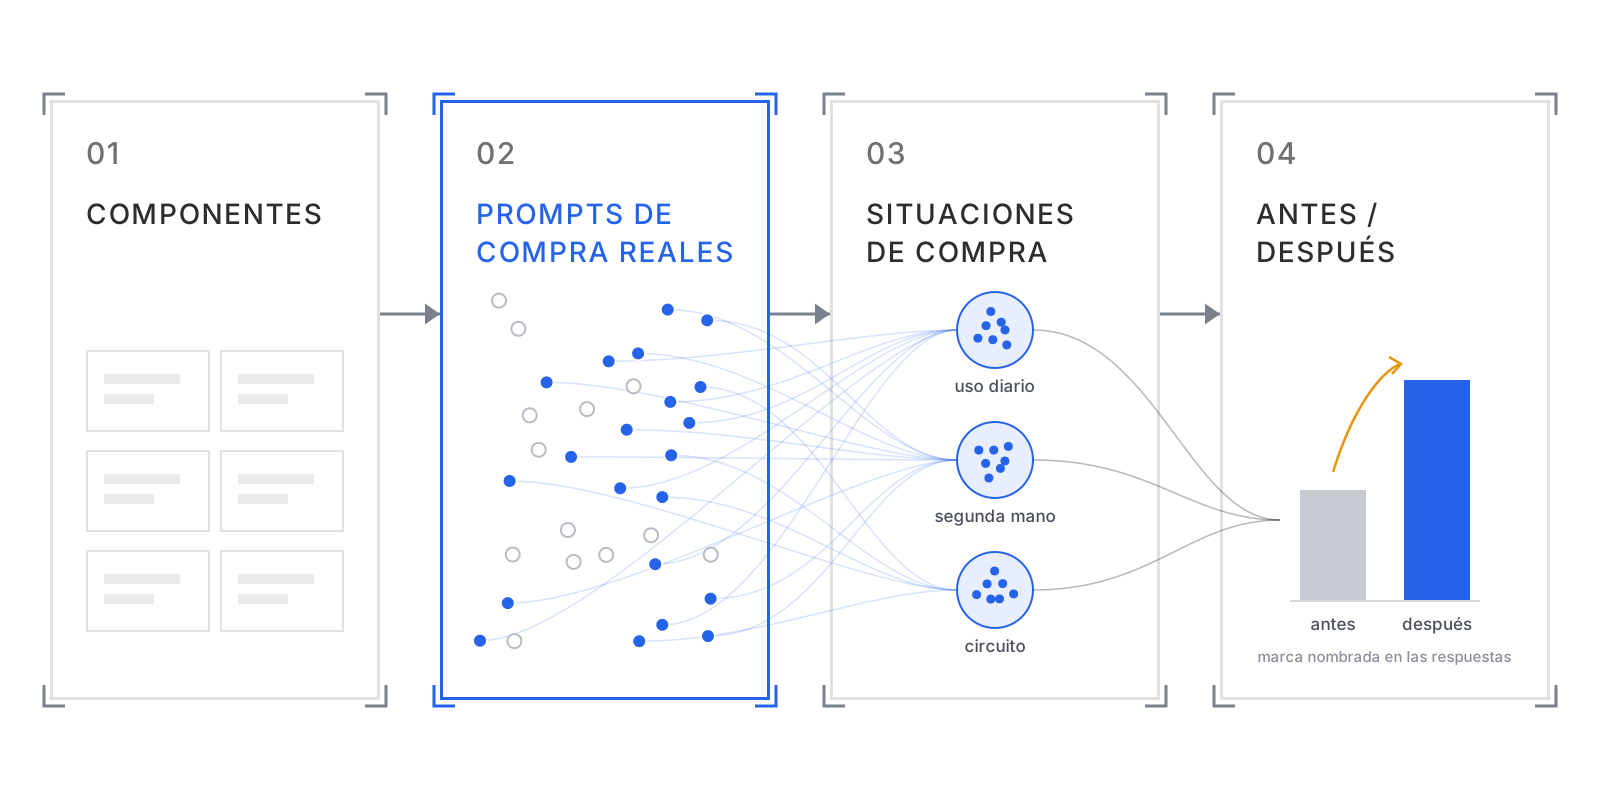
¿Qué prompts conviene seguir para una marca y cuánto pesa cada uno? Este es el método que aplicamos con cada cliente: el mismo proceso para todas las marcas y un resultado individual para cada una. Responde a siete preguntas, desde los componentes de una pregunta de compra hasta una medición de antes y después.
Puntos clave
Preguntas reales de compradores, no prompts inventados: las encontramos a partir de los componentes de cada oferta: variantes, tipos de producto, atributos, necesidades, públicos objetivo y contexto.
Agrupados y ponderados: los prompts forman situaciones de compra con un umbral de similitud de 0,93, y cada situación pesa según su volumen de búsqueda. Los prompts de marca tienen su propia puntuación.
El número depende de la precisión: unos 25 prompts reales por oferta dan un margen de ±10 puntos; 100 dan ±5.
Los mismos prompts antes y después: los clústeres en los que no trabajamos sirven de control. En una prueba sin cambios de contenido, el método no detectó ningún cambio.
Marca de ejemplo: Porsche. Porsche no es cliente de scaile. Todos los ejemplos de este artículo son ilustrativos.
Qué hacemos
El GEO abarca muchas cosas, pero no está estandarizado. La optimización para motores generativos es un campo muy diverso e individual: cada marca necesita su propio contenido. Por eso tenemos que entender de verdad a nuestros clientes antes de construir algo para ellos: qué vende exactamente un cliente, a quién y en qué contexto. Y todo eso hay que probarlo.
Así que desarrollamos un método que responde a una pregunta para cada cliente: qué prompts conviene seguir y cuánto importa cada uno. El proceso es el mismo para todas las marcas, pero el resultado es individual para cada cliente.
El método tiene cuatro fases: reunir las preguntas, planificar la prueba, medir y comprobar qué cambió nuestro contenido. A lo largo de esas cuatro fases, este artículo responde a siete preguntas.
1. ¿Cuáles son los componentes de una pregunta de compra?
Al principio definimos todas las ofertas de una marca. Además, creamos un grupo aparte para las preguntas sobre la marca en general.
Para cada oferta anotamos sus primeras palabras clave en un esquema fijo: variantes, tipos de producto, atributos, necesidades y problemas, públicos objetivo (ICP) y contexto.
Para el 911 queda así: las variantes son Carrera, 4, S, 4S, Turbo y Turbo S. Los tipos de producto, Coupé, Cabriolet y Targa. Los atributos, deportivo, aceleración, precio, seguridad y consumo. Las necesidades, conducir rápido, mostrar estatus, darse un capricho o ir a rodadas en circuito. Los públicos objetivo, personas con alto poder adquisitivo, aficionados a los coches y quienes lo usan para ir al trabajo. El contexto, nuevo, de segunda mano o en leasing.
¿Por qué este esquema? Nuestro objetivo es encontrar todas las preguntas que la gente podría hacer. Quien tiene una pregunta de compra sobre un producto tiene que describirlo de alguna forma: el modelo, la variante, una propiedad, una necesidad, quién es o su situación de compra. Cada una de esas descripciones es un valor de una de nuestras categorías. Así que cada prompt relevante contiene al menos una de nuestras palabras clave, o una combinación de varias. Esto sigue la clasificación por facetas, en la que las clases se construyen a partir de componentes (Hjørland, ISKO). Y nos facilita la tarea: en lugar de encontrar todos los prompts, tenemos que encontrar todos los componentes.

2. ¿Cómo se encuentran prompts reales?
Combinamos las palabras clave del esquema y buscamos con ellas prompts reales. Empezamos con combinaciones cortas y las alargamos paso a paso. Lo hacemos una vez con marca (con Porsche o 911 dentro) y otra sin marca. Para cada combinación buscamos donde la gente pregunta de verdad: registros de chat (WildChat, LMSYS), Reddit, foros, resultados de Google y datos internos de llamadas comerciales y del cliente.
Después clasificamos cada texto que encontramos. Primero: ¿es un prompt real o una consulta de búsqueda? Segundo: ¿cuánta intención de compra tiene: ninguna, leve, media o clara? Solo nos quedamos con prompts reales de intención media o clara que encajan con la oferta.
Ejemplo:
- Con “Cabriolet” (tipo de producto) encontramos “cabriolet para uso diario”. Es una consulta de búsqueda. Fuera.
- Con “Cabriolet + uso diario” (tipo de producto + necesidad) encontramos “Hago 40 km al día para ir al trabajo. ¿Qué Cabriolet es divertido y a la vez lo bastante cómodo para eso?”. Es un prompt con intención media. Se queda.
- Con “911 GTS” (oferta + variante) encontramos “¿Qué velocidad alcanza un 911 GTS?”. Es un prompt, pero sin intención de compra. Fuera.
- Con “911 GTS + primer Porsche” (oferta + variante + ICP) encontramos “Primer Porsche, presupuesto de unos 150.000. ¿Me compro un 911 GTS o un Carrera S?”. Es un prompt con intención clara. Se queda.

3. ¿Cómo sabemos que hemos encontrado suficientes?
Las primeras palabras clave son solo el principio. En cada ronda encontramos palabras clave nuevas, por ejemplo en los apartados “Otras preguntas de los usuarios” y “La gente también busca” de Google, y volvemos a buscar con ellas prompts de compra reales. Las palabras clave son el cebo; los prompts de compra, la captura. Paramos cuando una ronda añade menos del 5 % o menos de 3 prompts de compra nuevos.
Probamos este ciclo con 10 ofertas y 4.009 prompts de compra. Las palabras clave iniciales por sí solas encontraron solo el 53 % de los prompts de compra que encontró el ciclo completo. La mayoría de los prompts aparecen pronto: el 85 % tras dos rondas. Las rondas posteriores a la parada habrían añadido solo un 0,2 %.
También comparamos nuestro método con la búsqueda libre de investigadores independientes, con el mismo presupuesto (60 búsquedas por oferta), en un archivo de textos que ambos recorrieron entero (Reddit, foros, registros de chat). Nuestro método encontró el 97 % de los prompts de compra que encontró la búsqueda libre (2.101 de 2.176), más al menos 291 que la búsqueda libre pasó por alto.
Las palabras clave del esquema que nunca aparecen en un prompt real van a una lista de huecos. Muestra dónde los compradores todavía no han preguntado, o dónde todavía no los hemos encontrado.

4. ¿Cómo se agrupan los prompts?
Para cada oferta agrupamos los prompts por significado en intenciones de compra. Cada prompt se convierte en un vector, y los prompts de significado parecido quedan cerca unos de otros. Un clúster es una situación de compra, por ejemplo “uso diario” o “comprar de segunda mano”. Más adelante se ve en qué situaciones es visible una marca y en cuáles no.
El umbral es una similitud de 0,93. Probamos varios umbrales comparándolos con las respuestas de la IA: ¿cuánto se parecen las respuestas a prompts del mismo clúster? A partir de 0,92 a 0,94, unos clústeres más finos apenas hacen más parecidas las respuestas. Pero aparecen muchos más clústeres con un solo prompt, y los clústeres se vuelven menos estables. Con 0,93, las respuestas dentro de un clúster se parecían casi tanto como con 0,95 (distancia entre respuestas de 0,046 frente a 0,044), y los clústeres eran más estables (0,94 frente a 0,91).
Un resultado nos sorprendió: incluso dos preguntas reales muy parecidas reciben respuestas más distintas que una pregunta y su reformulación. Por tanto, un clúster es un grupo con la misma intención de compra, no un grupo con la misma respuesta.

5. ¿Cuántos prompts hacen falta?
No hay un número general para una empresa, pero sí uno para cada nivel de precisión. El error de una media se reduce con más prompts: SEM = σ / √N. σ es la dispersión entre prompts. Según nuestras pruebas ronda 0,25; 0,5 es el peor caso. Con un 95 % de certeza, el valor real está dentro de aproximadamente ±2 × SEM. Así que necesitamos N = (σ / SEM)² prompts.
- SEM 0,05: ±10 puntos, 25 prompts (σ = 0,25), 100 prompts (σ = 0,5)
- SEM 0,04: ±8 puntos, 40 / 157
- SEM 0,03: ±6 puntos, 70 / 278
- SEM 0,025: ±5 puntos, 100 / 400
- SEM 0,02: ±4 puntos, 157 / 625
- SEM 0,01: ±2 puntos, 625 / 2.500
Para ±10 puntos necesitamos 25 prompts reales por oferta; para ±5 puntos, ya 100. Antes de la prueba decidimos qué precisión necesita cada oferta.

6. ¿Cómo se ponderan los resultados?
Las ponderaciones hacen que las situaciones importantes pesen más, de modo que la puntuación refleje lo que los compradores preguntan de verdad. Las usamos dos veces. De clústeres a oferta: cada clúster pesa según su volumen de búsqueda (DataForSEO). De ofertas a marca: cada oferta pesa según su peso de mercado y un peso individual del cliente.
- Puntuación por clúster = proporción de respuestas que nombran la marca.
- Puntuación por oferta = puntuaciones de los clústeres multiplicadas por sus pesos y sumadas.
- Puntuación de la marca = puntuaciones de las ofertas multiplicadas por sus pesos y sumadas. Una vez con los pesos del cliente y otra con los pesos de mercado.
Los prompts de marca tienen su propia puntuación y nunca se mezclan con la puntuación principal.
Los pesos también deciden cuántos prompts recibe cada clúster. Ejemplo del 911, 25 prompts para ±10 puntos:
- Uso diario: 50 % del volumen de búsqueda, 50 % × 25 = 12,5, se prueban 13
- Segunda mano: 30 %, 7,5, se prueban 8
- Rodadas en circuito: 20 %, 5, se prueban 5
- Total: 26 prompts
Para ganar certeza, primero fijamos el número de prompts por clúster según su peso y después sumamos, no al revés. Tomar el mismo número de prompts para cada clúster y aplicar luego los pesos aumentaría el error.
Solo probamos prompts reales, sin reformulaciones. En nuestras pruebas, una reformulación aportó solo una cuarta parte de la información de una pregunta real nueva. Y a veces medía otra cosa: una pregunta real sobre un tensiómetro que envía sus resultados a una app nombró la marca en 20 de 20 ejecuciones; la reformulación “Recomiéndame un tensiómetro con Bluetooth”, solo en 5 de 20. Si un clúster tiene menos prompts reales de los que necesita, lo probamos con los que tiene, informamos de un margen más amplio y volvemos a buscar para esa situación de compra.

7. ¿Cómo se mide lo que cambió?
Medimos a través de un endpoint de OpenAI en el que el modelo escribe sus propias búsquedas web (fan-out). Cada prompt se ejecuta 5 veces. Cuenta como mención cuando el nombre de la marca aparece en la respuesta o el dominio de la marca está entre las fuentes citadas.
Antes de empezar el trabajo de contenido, dejamos por escrito en qué clústeres vamos a trabajar. Tras el trabajo de contenido volvemos a medir, exactamente con los mismos prompts. Después comparamos por prompt (después menos antes) y, por clúster, el cambio medio con su error. Los clústeres en los que no trabajamos son el control. Si también se mueven, lo más probable es que se trate de una actualización del modelo y no de nuestro contenido.
Para ver un cambio de unos 5 puntos necesitamos unos 64 prompts con 5 ejecuciones por grupo de clústeres. El cambio de un solo prompt entre dos mediciones tiene una dispersión de unos 0,20 y nunca superó 0,25 (378 prompts, medidos tres veces).
También comprobamos si la medición muestra cambios que no se produjeron. Medimos los mismos 378 prompts tres veces sin ningún cambio de contenido (5.646 respuestas). La tasa de marca fue de 0,202, 0,192 y 0,192. Solo 2 de 195 comparaciones de clústeres parecían significativas (el azar por sí solo da alrededor de un 5 %) y ninguna tras corregir por comparaciones múltiples. Es decir, el método no inventa cambios.

En qué ayuda
- Los prompts correctos. El conjunto de prompts refleja lo que preguntan de verdad los compradores de esta marca, no lo que suponemos que preguntan.
- Pesos que importan. Las situaciones de compra con más demanda pesan más.
- Precisión conocida. Cada cifra lleva su margen, y sabemos cuántos prompts hacen falta para conseguirlo.
- Huecos visibles. Las palabras clave sin prompts reales muestran dónde los compradores aún no preguntan, o dónde aún no los hemos encontrado.
Por qué funciona
- Preguntas reales en lugar de prompts inventados. Las palabras clave solo indican dónde buscar. Lo que seguimos procede de compradores reales.
- El mismo proceso para cada cliente, un resultado individual. Una marca de deportivos y un fabricante de dispositivos médicos acaban con conjuntos de prompts muy distintos.
- Un conjunto fijo. Como el conjunto no cambia, podemos comparar mediciones a lo largo del tiempo y ver qué cambió nuestro contenido.
Resultado
Al final, cada cliente tiene:
- un mapa de todo lo que vende la marca, con palabras clave en seis categorías y dos pesos por oferta,
- un conjunto de prompts construido a partir de preguntas reales de compradores, agrupadas en situaciones de compra ponderadas,
- el número de prompts necesario para la precisión que buscamos, y cómo se reparten entre los clústeres,
- una lista de huecos con palabras clave y situaciones sin suficientes prompts reales,
- una medición de antes y después que muestra qué cambió nuestro contenido.
Lo que aún no sabemos:
- No hay datos públicos sobre la frecuencia con la que se hace un prompt concreto. Usamos el volumen de búsqueda como aproximación de la demanda.
- Con 0,93, una evaluación a ciegas encontró 2 de 10 a 12 clústeres que mezclaban intenciones de compra distintas. Leemos cada clúster y marcamos los mixtos.
- La prueba del umbral y las mediciones repetidas se han hecho, por ahora, con una sola marca.
- Sabemos que el método no inventa cambios. Si detecta todos los cambios reales está aún por probar con un cambio de contenido conocido.
- Las respuestas proceden de una API, no de la app de ChatGPT. Las actualizaciones del modelo pueden cambiar las respuestas, por eso repetimos las mediciones y registramos la versión del modelo.